Лучшая нейросеть для создания превью: проверка правкой
Лучшая нейросеть для создания превью зависит от следующей правки. Показываю готовую миниатюру LibraChat с буквами и сравниваю процессы Canva и Adobe Express.
Д
Денис
Продакт LibraChat
11 мин чтения
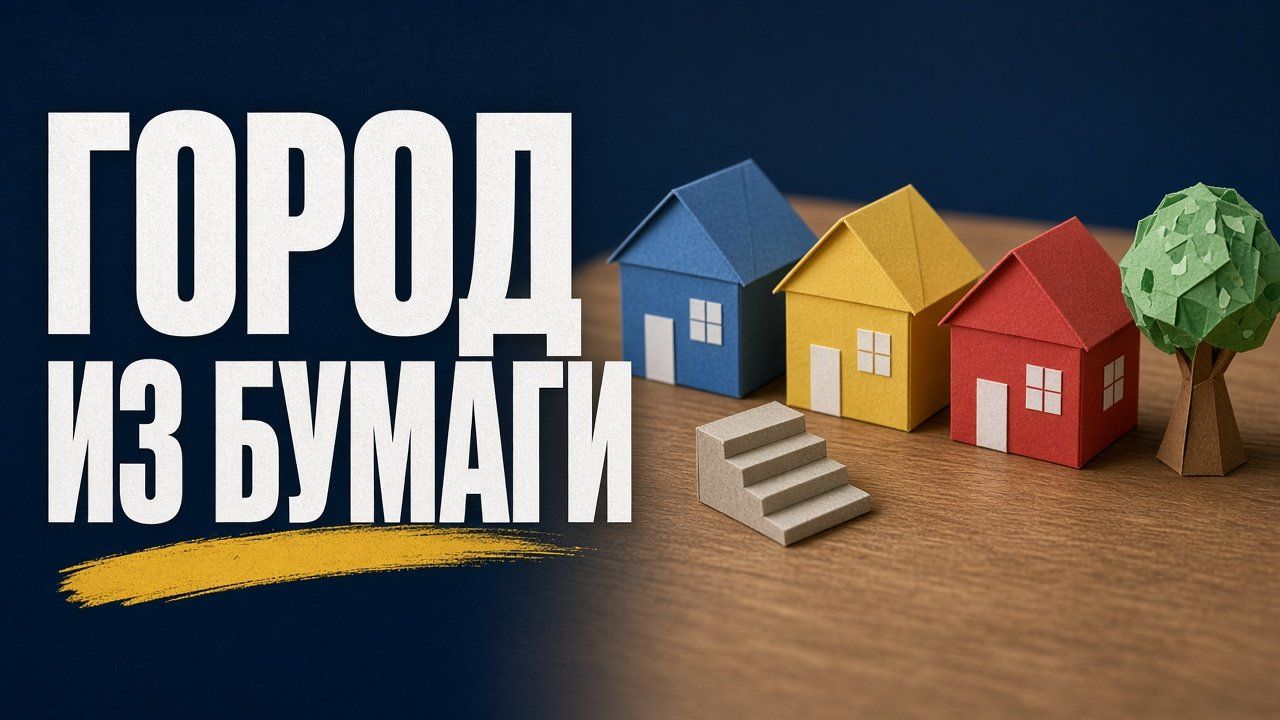
«ГОРОД ИЗ БУМАГИ» — все три слова появились на полученной миниатюре, рядом стоят три картонных домика. Заголовок уже внутри изображения. Но если завтра понадобится заменить «ГОРОД» на «ДЕРЕВНЯ», у меня будет другая задача. Поэтому лучшая нейросеть для создания превью определяется ещё и тем, что ты собираешься делать со следующим выпуском.
Я подготовил законченный демонстрационный вариант для учебного видео о бумажном макете. Не просто красивую сцену с пустым местом слева: в запрос вошли надпись, её строки и распределение объектов. Результат покажу ниже. На нём удобно разобрать четыре заблуждения, из-за которых выбор инструмента начинается с обещаний генератора, а заканчивается неожиданной работой в редакторе.
Миф: лучшая нейросеть для создания превью рисует всё сама
Слово «превью» скрывает несколько разных результатов. Одному автору нужна новая сцена для ролика, другому — обложка из настоящего кадра, третьему — серия с одинаковым шрифтом. Если сравнить их только по способности нарисовать картинку, важная часть работы останется за пределами сравнения. Особенно заметно это на заголовке.
Мне хотелось проверить завершённую композицию. В ней зритель должен сразу встретить предмет видео и короткую подпись, а автор — получить изображение, которое можно осмысленно оценить целиком. Я оставил справа бумажные домики, слева большие буквы. Нижний правый угол попросил не занимать важными деталями: при размещении миниатюры в интерфейсе края и служебные элементы тоже приходится учитывать.
Перед запросом я записал четыре условия:
надпись совпадает с заданными словами, без придуманного продолжения;
предмет видео узнаётся без чтения описания под ним;
текст и предмет не борются за один и тот же участок;
композиция сохраняет поля, а нужные части не уходят за границу.
Это моя приёмка для демонстрационного макета, а не измерение будущих просмотров. Само видео здесь не публиковалось. Бумажный город выбран как понятная учебная сцена: зритель должен ожидать работу с картоном, а не обзор настоящего района или компьютерную игру.
Сделай картинку: готовая горизонтальная миниатюра 16:9 для учебного видео о макете города из бумаги. Справа крупно покажи три разноцветных домика из сложенного картона, лестницу и маленькое бумажное дерево на рабочем столе; вид под небольшим углом, заметны бумажные сгибы. Слева на ровном тёмно-синем поле размести точную русскую надпись «ГОРОД ИЗ БУМАГИ» большими белыми печатными буквами: «ГОРОД» в первой строке, «ИЗ БУМАГИ» во второй. Буквы должны свободно помещаться внутри кадра и читаться на маленькой миниатюре. Нижний правый угол оставь спокойным и без важных деталей. Тёплый жёлтый акцент связывает буквы и домики. Это законченная композиция с заголовком, а не фон под будущую надпись.
Настоящий результат LibraChat: законченная композиция с русским заголовком, JPEG 1280×720.
*Настоящий результат LibraChat, пример e1: JPEG 1280×720. Надпись и бумажный город уже собраны в одной горизонтальной композиции.*
Я открыл сам файл. Слова написаны верно, строк две, домиков три: синий, жёлтый и красный. Лестница вынесена перед ними, дерево стоит у правого края. Жёлтый мазок под буквами связывает левую часть с центральным домиком. Это можно обсуждать как готовый вариант миниатюры, а не как обещание когда-нибудь добавить текст.
Есть и тесные места. Вторая строка подходит близко к зоне с домиками, дерево касается правой границы. Я бы проверил их на конкретном показе площадки перед выпуском. Само наличие читаемых букв в открытом файле ещё не подтверждает удобство на каждом телефоне. Но здесь уже есть предмет проверки: вся композиция, включая заголовок.
Успех одного запроса не означает, что любой текст получится так же. Он показывает более узкую вещь: в этом результате LibraChat действительно собрал нужные слова и сцену. Теперь я могу решить, подходит ли такой вид результата моей работе. Следующий вопрос оказывается практичнее общего спора о качестве нейросетей.
Миф: надпись на картинке равна редактируемому заголовку
В полученном JPEG буквы видны, но отдельный текстовый объект вместе с ним не появился. Я не получил подтверждённый проект, где можно выделить слово и набрать другое с клавиатуры. Это различие легко пропустить, когда первая версия устраивает: файл открывается, надпись правильная, хочется считать работу полностью решённой.
Представим следующую редактуру: город в ролике становится деревней, а домики должны остаться прежними. Для изображения с уже нарисованными буквами придётся выбирать способ изменения. Можно попросить правку в том же чате — такая возможность есть в LibraChat. Но я не проверял на этом макете, сохранятся ли остальные детали при замене слова. Обещать неизменность домов было бы лишним.
Для регулярных текстовых замен я рассматриваю редактор с надписью как элементом макета. Canva на своей странице создания миниатюр описывает шаблоны, добавление текста и выбор шрифтов; там же доступны операции с изображением через ИИ-редактор. Это документированный путь, когда у тебя уже есть кадр или иллюстрация, а заголовок нужно размещать и изменять отдельно от них.
Adobe Express описывает начало с шаблона или пустого холста, добавление своих фотографий и применение оформления канала. На той же странице есть генерация изображений и шаблонов по запросу. Для меня это другой порядок сборки: сначала определить устройство макета и только затем решать, какой его части требуется генерация.
Я сверил публичное описание этих функций, но не создавал в Canva и Adobe Express копии нашего бумажного города. Поэтому таблица ниже сравнивает операции и форму результата. Она не присваивает баллы за красоту или правильность букв по несуществующему общему испытанию.
Что предстоит сделать · Какой процесс рассматриваю · Что проверяю перед выбором
Придумать сцену и сразу увидеть её с короткой надписью — Запрос законченной миниатюры в LibraChat; реальный вариант показан выше — Слова, предмет, границы и формат полученного файла
Собрать миниатюру из своего кадра, менять шрифт и заголовок — Текст и элементы макета в Canva по описанному процессу — Удобство конкретной замены и доступ нужных элементов
Продолжать оформление канала через повторяемый проект — Шаблон и оформление в Adobe Express по документации — Какие части остаются одинаковыми, что меняется в выпуске
Изменить одну деталь уже полученной картинки — Правка в чате LibraChat или подходящая операция редактора — Сохранилось ли всё, что автор просил оставить
В этой таблице нет универсального победителя. У разового ролика и еженедельной серии разные затраты на исправления. Если заголовок согласуют несколько раз, возможность быстро поменять одну строку становится важнее того, насколько эффектно появилась первая картинка. Я выбираю по ожидаемой редактуре, а не по впечатлению от её появления.
Отдельно решаю, нужен ли здесь настоящий кадр. Если автор учит собирать определённый макет и обещает показать его устройство, зрителю полезно увидеть именно тот предмет, который появится в видео. Сгенерированные домики могут оказаться привлекательными, но не совпасть с реальной работой. Тогда я возьму свой кадр за основу, а генерацию оставлю для тех элементов, которые не искажают содержание.
У моего примера другая роль: показать законченную композицию для условного учебного сюжета. Я не выдаю эти дома за снятую мной поделку и не утверждаю, что по ним уже записан урок. Такое различие влияет на выбор раньше шрифтов. Редактор, позволяющий спокойно собрать собственный кадр и заголовок, может оказаться подходящим решением даже при наличии сильного генератора новых сцен.
Есть простой антипример: «Сделай превью, чтобы захотели нажать». Такой запрос не задаёт ни содержание, ни обязательные слова, ни допустимые обещания. Даже выразительный результат трудно принять: неизвестно, что именно он должен объяснять зрителю. В моём запросе вместо этой общей оценки стоят бумажные дома и точная надпись. Исправления хотя бы можно обсуждать предметно.
Миф: один удачный выпуск — уже шаблон канала
У бумажного города получилась своя композиция. Для соседнего видео о картонном мосте она может оказаться неудобной: мост вытянут, надпись другой длины, а важная деталь расположена не там, где крыши домиков. Копирование картинки и повторение принципа оформления — разные действия. Второе требует заранее определить, что именно должно повторяться.
Я бы оставил постоянными тёмное поле, крупный светлый заголовок и небольшой тёплый акцент. Сюжетную часть разрешил бы менять. Это проектное решение для будущей серии, не отчёт о созданных вариантах: мост и следующую миниатюру я здесь не генерировал. Такой план помогает проверить инструмент ещё до того, как серия станет срочной работой.
Повторяемый выпуск удобно описывать через три группы:
постоянное: цвета, положение названия, характер надписи;
заменяемое: предмет ролика, короткие слова, при необходимости фон;
проверяемое заново: длина строки, пересечения, соответствие содержанию видео.
Затем я выбираю, где хранить постоянную часть. Adobe Express описывает превращение нового или существующего проекта в шаблон, которым можно поделиться. Canva предлагает готовые миниатюрные макеты для дальнейшего оформления. Это основания рассматривать редакторы для серии. Они не доказывают, что любой выбранный шаблон уже подходит конкретному каналу: содержание и расположение всё равно надо проверить.
LibraChat полезен мне на этапе нового образа и получения цельного варианта по описанию. В чате можно продолжить обсуждение и попросить изменение. Но из одного JPEG я не вывожу возможность автоматически выпускать серию с неизменным шрифтом, геометрией домов и расстояниями. Если нужна именно такая стабильность, сначала проверяю отдельную повторную операцию, а не сразу заказываю десять картинок.
До серии есть смысл посмотреть условия работы с изображениями. Тариф влияет на доступный объём и качество; подробное сравнение доступно на экране тарифов после входа, личные остатки — в разделе использования. Один показанный результат не даёт оснований обещать читателю столько же попыток в его аккаунте.
Цена первой миниатюры тоже не описывает стоимость всего процесса. Допустим, автору предстоит несколько редакторских согласований каждого заголовка. Тогда я сравню не только доступ к генерации, но и число действий при замене слов, способ хранения версии и необходимость заново проверять изображение. Это вопросы организации работы; конкретные цены и доступность выбранных сервисов нужно смотреть отдельно.
Самая полезная проба для будущей серии — небольшая и требовательная. Оставить композицию, поменять одну надпись, затем сравнить все неизменяемые части. Если инструмент каждый раз заставляет пересматривать весь кадр, я учитываю это заранее. Если текст редактируется отдельно, всё равно смотрю перенос строк: более длинное слово может разрушить хороший первый макет.
Миф: размер по умолчанию решает всё
Реальный файл из моего запроса имеет 1280×720 пикселей и пропорцию 16:9. Это измеренный размер полученного примера. Он не становится актуальной рекомендацией YouTube только потому, что похожие числа часто встречаются в старых инструкциях или на страницах редакторов. Площадка устанавливает собственные требования, и её справка важнее привычного пресета.
На момент сверки справка YouTube рекомендует для миниатюр обычных видео 3840×2160, формат JPG или PNG и пропорцию 16:9. Ограничение размера файла различается для загрузки с мобильного устройства и компьютера. Я не загружал наш пример в YouTube Studio и не проверял принятие файла: здесь показан результат генерации, а не завершённая публикация ролика.
Поэтому мой порядок приёмки идёт от смысла к технической подготовке:
Сверить обещание миниатюры с тем, что действительно есть в видео.
Прочитать каждое слово и проверить, не теряется ли предмет рядом с ним.
Посмотреть всю композицию в предполагаемом размере показа, включая края.
Сверить текущие требования места загрузки: пропорции, разрешение, формат и вес.
Подготовить нужный файл и ещё раз открыть его перед отправкой.
Пункт про уменьшенный показ — предлагаемая проверка, а не заявленный тест на чужом устройстве. Отдельную уменьшенную копию я для этого разбора не экспортировал. У зрителя на телефоне домики и буквы будут занимать меньше места, чем в открытом изображении выше. Мне нужно убедиться, что он видит тему, а не только яркое сочетание синего и жёлтого.
Если чат вместо изображения вернул объяснение будущего дизайна, работа останавливается ещё раньше. В таком случае полезна история генератора превью для YouTube: там разобраны реальные попытки получить картинку и дальнейшая работа с заголовком. Здесь я проверял более полную единицу результата — сцену вместе с буквами. Эти два этапа стоит различать при постановке задачи.
Я возвращаюсь к начальным трём словам. В показанном файле они уже есть, и для разового демонстрационного варианта это существенный результат. Для следующего выпуска я сначала написал бы на листе: «Заменить ГОРОД на ДЕРЕВНЯ, всё остальное сохранить». Способ выполнить именно эту правку и станет моим следующим критерием выбора. Сформулируй такую замену для своего ролика до того, как начнёшь выбирать нейросеть по самой эффектной первой картинке.